


OpenAI Jalapeño芯片横空出世:9个月挑战英伟达霸权
当全球科技界的目光仍聚焦于英伟达(NVIDIA)在AI算力领域的绝对统治地位时,一场悄无声息的颠覆已然上演。OpenAI首颗自研ASIC芯片Jalapeño的亮相,不仅是一个引人注目的产品发布,更标志着AI产业正从根本上重新定义芯片的设计范式与竞争格局。
据媒体报道,这款由OpenAI与博通(Broadcom)联手打造的推理芯片,在单位功耗AI处理能力与响应速度两大关键维度上,已实现对英伟达旗舰产品GB300的全面超越,预计最快将于今年晚些时候投入实际部署。
速度奇迹:16个月完成流片,9个月实现超越
对于半导体行业而言,一款高性能芯片从设计到流片通常需要18至36个月的漫长周期。然而,Jalapeño的诞生彻底打破了这一惯例。根据半导体研究机构SemiAnalysis的深度报告,该芯片从设计启动到完成流片仅耗时约16个月,而其关键的CoWoS封装流片节点在2025年11月便已达成。值得注意的是,从流片成功到性能实测超越行业巨头,仅仅过去了9个月。这种令人咋舌的开发速度,很大程度上归功于AI工具在芯片设计流程中的深度参与。
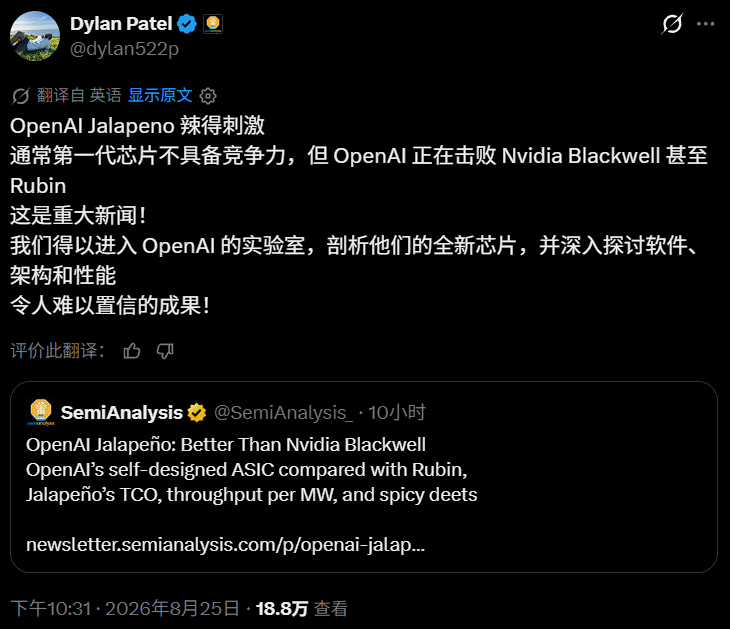
SemiAnalysis的研究人员亲赴OpenAI实验室,利用其自研的InferenceX基准测试套件对Jalapeño进行了严苛的实测。结论相当直接:在每瓦性能(perf/W)这一核心能效指标上,Jalapeño击败了他们此前测试过的所有英伟达、AMD及谷歌芯片。 这一成绩的取得,甚至是在Jalapeño尚未启用投机解码、也未进行预填充与解码分离部署等进一步优化手段的“素颜”状态下。作为对比,参与测试的其他竞品均已开启各自的最优配置。这也难怪著名半导体分析师Dylan Patel会发出惊叹:“被掀翻的不只是Blackwell,就连英伟达的下一代Rubin芯片也被超越了!”
实测数据:能效与成本的全面碾压
SemiAnalysis的测试数据勾勒出了一幅极具冲击力的性能对比图谱。
- 模型推理吞吐量: 在GPT-OSS 120B模型上,Jalapeño每秒可输出约1459个Token,而英伟达GB200仅为535个。
- 端到端延迟: 完成一个任务,Jalapeño仅需1.65秒,GB300则需接近6秒,性能差距高达3.6倍。在高交互场景下,当GB300被推至最快解码速度(每秒169个Token)时,Jalapeño的吞吐量更是其104.3倍。
- 数据中心能效核心指标: 在衡量每兆瓦每秒输出Token数的关键指标上,Jalapeño在GPT-OSS模型上达到约5300万个Token/MW/s,而GB200 NVL72仅约1000万。SemiAnalysis指出,这一指标决定了算力受电力约束下的数据中心收入天花板。
- 系统级总拥有成本(TCO): 将供电、散热、网络全部纳入计算后,Jalapeño每芯片每小时总拥有成本约为1.56美元,与H100的1.55美元几乎持平,而英伟达下一代Vera Rubin则高达3.61美元。
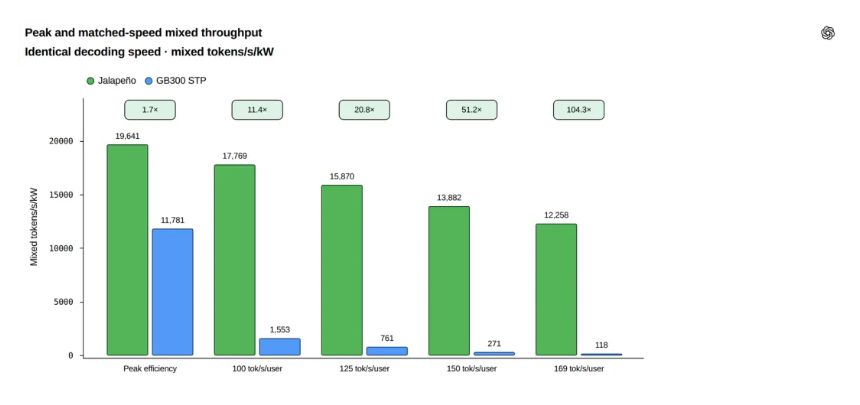
尽管数据斐然,SemiAnalysis也提出了极具专业性的保留意见:
- 测试所用模型并非当前最前沿的模型,Jalapeño尚未完成更能反映真实生产场景(多轮、长上下文)的AgentX套件测试。
- 更公平的比较对象应是同样采用HBM4内存的英伟达Vera Rubin,而非Blackwell系列。Vera Rubin的每瓦性能较GB200 NVL72提升约5.4倍,与Jalapeño在每Token TCO上几乎不相上下。
- Jalapeño目前仍处于工程样片(A0步进)阶段,量产爬坡预计要到2027年。
AI设计芯片:一场正在发生的“飞轮效应”
Jalapeño之所以能以惊人之速突破性能壁垒,其核心驱动力之一便是AI工具的深度介入。OpenAI在芯片设计过程中大量使用了其内部AI模型,特别是备受外界关注的GPT-Astra和Codex。
据X平台用户Andrew Curran引述OpenAI信息指出,团队借助Codex与GPT-Astra,在两个月内将三个原本不在Jalapeño量产计划内的开源模型调优至高性能状态。AI不仅在设计加速上贡献力量,还快速扩展了芯片所能支持的模型范围。SemiAnalysis的数据量化了这一贡献:AI辅助设计使SIMD单元面积缩减8%,矩阵引擎面积缩减10%,同时在时序和功耗表现上均优于初始版本。在软件层面,OpenAI使用内部扩展版Codex编写Jalapeño内核,部分内核代码长达约3000行;在最吃性能的注意力机制和MoE模块上,AI生成的代码比人类顶尖工程师的实现快出1.5至1.8倍。
SemiAnalysis对此评价犀利:跑在英伟达GPU上的OpenAI模型(如GPT-5.6 Sol),正被用来设计一颗对CUDA护城河构成真实威胁的芯片——“英伟达自己的GPU正在实时催生自己潜在的接班人”。
架构解析:“通用”与“低延迟”的极致追求
与外界普遍预设的不同,Jalapeño并非一颗专为OpenAI自家模型深度定制的专用芯片,而是一颗面向AI推理的通用芯片,能够高效运行各类模型和工作负载。其核心设计哲学是“消除固定延迟”。
- 直连内存架构: 与GPU依赖复杂内存层级不同,Jalapeño将计算核心与HBM切片直接绑定,核心间通过专用高带宽集合网络同步,大幅降低内存访问延迟。
- 乱序执行(OoO)核心: 采用乱序执行核心搭配L1缓存,而非其他加速器普遍使用的软件管理暂存器,使其在小批量、低延迟场景下能更接近硬件理论峰值。
- HBM4内存带宽优势: Jalapeño采用HBM4内存,实现了15.4TB/s的单封装内存带宽,每瓦HBM带宽达22,而英伟达Rubin为11.1,GB300仅为5.71。其HBM4引脚速度达10Gbps,略高于Rubin的9.6Gbps。
此外,Jalapeño有意不做预填充与解码分离部署(PDD)。SemiAnalysis解释,在真实生产环境中,输入输出比例、并发量、缓存命中率等参数持续变化,同构资源池可以灵活响应流量变化,避免固定分池导致的全局利用率下降。
CUDA护城河或将失守?软件生态的弯道超车
长久以来,CUDA软件生态被视为英伟达最坚固的护城河。但SemiAnalysis抛出重磅判断:CUDA的护城河可能已经出现裂缝,甚至面临死亡威胁。 其依据在于软件起步速度的对比。英伟达Rubin的CoWoS流片比Jalapeño早一个月完成,但至今外界能看到的Rubin公开基准数据仅来自CoreWeave的工程样片。相比之下,OpenAI则开放第三方进入实验室自由测试。这反映的并非硬件本身的差距,而是软件成熟度的差距。
从零开始构建软件栈,反而让OpenAI得以摆脱历史包袱,做出更干净的架构决策。OpenAI使用自研内核编程语言Gluon(基于Triton构建)以及内部推理引擎“Teacup”,并借助Codex快速完成内核调优。SemiAnalysis观察到,在不到两周的时间内,Jalapeño在特定交互速度下的吞吐量提升超过2倍;在8天内,团队将张量并行从TP8扩展至TP32,实现了跨机架的全机柜规模部署。
未来版图:B0步进与10GW雄心
Jalapeño的故事远未结束。目前公开测试所用的均为A0步进样片,而B0步进已进入晶圆厂,预计在每瓦性能上较A0再提升约25%。B0单颗计算die的MXFP4算力将达13.4 PFLOPs,TDP维持在700W。
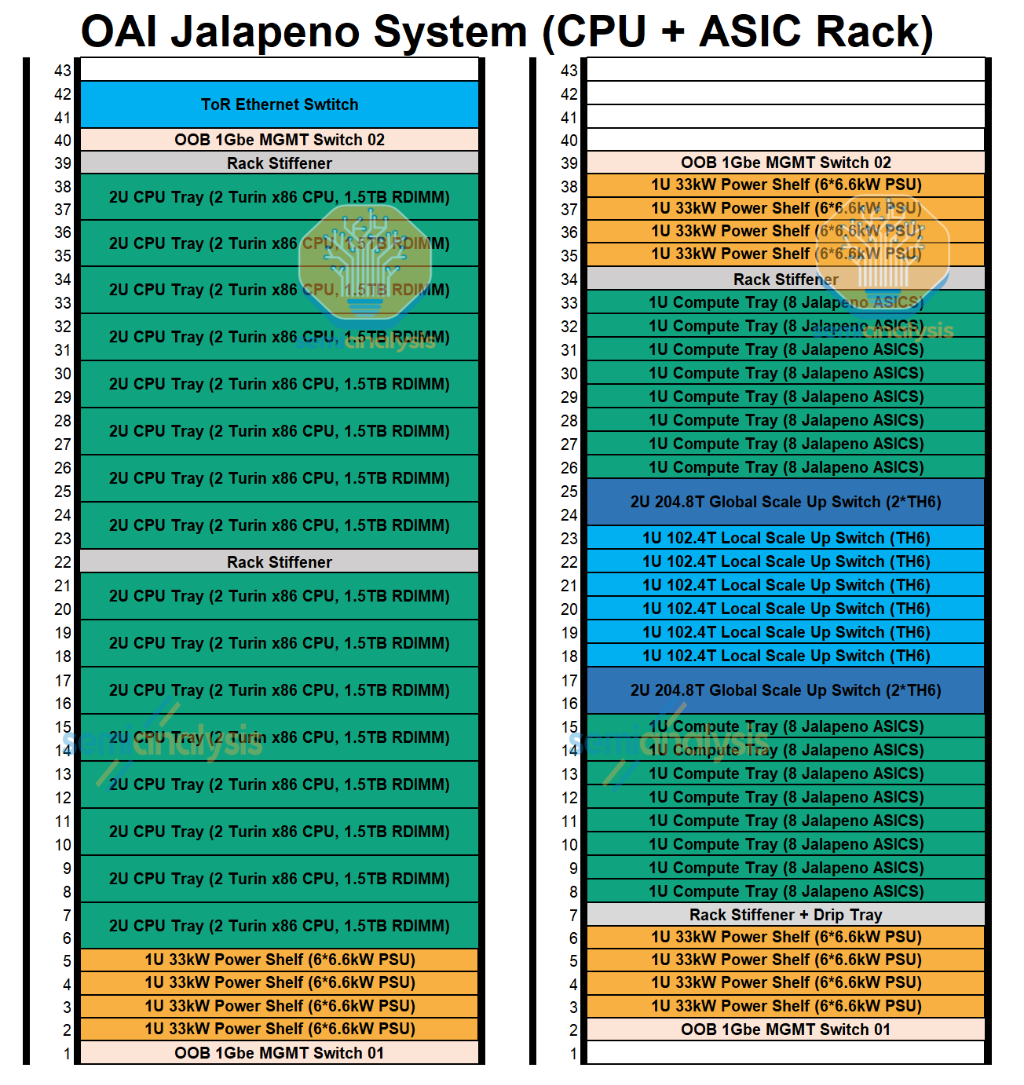
在系统层面,OpenAI与Celestica合作设计了完整机架方案:每个ASIC机柜包含128颗Jalapeño芯片,双机柜系统总功耗约160kW,与英伟达GB300双宽机柜相当。规模化部署方面,单一扩展网络域最多可连接2048颗Jalapeño XPU,覆盖16个机架。量产预计于2027年逐步爬坡,下一个里程碑目标是100MW部署规模。
更大的战略图景是,OpenAI与博通已签署10GW定制加速器合作协议,这一量级大致相当于十座核电机组的满发功率,彰显了其构建自主AI算力帝国的雄心。OpenAI芯片负责人Richard Ho表示,公司已达到能切实降低基础设施成本的功耗和成本水平,“这只是第一步”,并强调英伟达仍是重要合作伙伴。
市场资讯部视点
Jalapeño的横空出世绝非一次简单的产品迭代,它是对硅谷传统芯片设计流程与商业模式的“暴力”解构。在AI的辅助下,芯片设计的门槛与周期被大幅压缩,这严重动摇了以英伟达CUDA生态为核心的高壁垒护城河。尽管Jalapeño在量产成熟度与复杂工作负载上仍需时间证明,但其在能效与TCO上的显著优势,为AI算力市场投下了一枚重磅炸弹。对于云计算厂商与大型模型公司而言,这意味着未来在算力采购上将拥有更多制衡英伟达的筹码。这场由AI引发的“自我革命”,正在加速半导体产业向更高效、更开放的范式演进,其影响将远远超出华尔街的预期。







